
所有筆記 · 發布於 2026-10-15
預估分數的第二次體檢:140 份真實成績,平均誤差 −6,但我們之前看錯了一件事
八月時我們用四張寄回來的成績單檢驗預估分數,後來累積到八張,看起來有一個清楚的結論:高分的考生,閱讀被低估。這次我們不等人寄了,直接把 1,019 份有輸入正式成績的雲端備份攤開,清掉重複、自填和不可靠的項目,留下 140 組「輸入成績前的預估對正式成績」。結果:預估整體沒有偏差(總分平均差 −6,中位數 0),排序相關 0.83;而「高分被低估」是取樣造成的錯覺。真正站得住的發現只有一個半,另外一個我們以為有、其實沒有。
〈多益預估分數準不準?〉的結尾寫了三種閱讀偏差,每一種都有名字,講得很篤定。那篇用的是四位主動寄成績回來的考生,後來實戰報告陸續加到八張成績單,八張裡有六位 700 分以上的考生,其中五位的閱讀被低估、一位剛好,最多的一位低了 125 分。我們開始認真考慮要不要在高分帶把預估往上調。
動手之前,先做一件早該做的事:看全部的人,而不是寄信來的人。
資料從哪裡來,怎麼清
App 裡輸入正式成績的功能上線以來,雲端備份裡有 1,019 個帳號留下了至少一筆正式成績。每一筆成績都有一個日期,每個帳號都有一條每日預估的軌跡,所以可以做和實戰報告一樣的事:拿輸入成績之前的預估,對上輸入的成績。
這裡有一個我們一開始沒看清楚的細節。輸入成績的表單,只有在目標設定裡的考試日期剛過不久時,才會預填那個考試日期;其他情況預填的是「今天」。所以紀錄裡的日期,有些是真正的考試日,更多是輸入成績的那一天。成績單通常在考後兩週左右寄到,所以「輸入前的預估」多半是考後一到四週的預估,不是嚴格的「考前一天」。這一篇從頭到尾比的,是考生拿到成績、把它輸入 App 之前,App 最後給的預估,取輸入前兩天到十四天之間的最後一筆;更早的不算,輸入當天和前一天也不算,因為輸入成績會把當天的預估重設成那個分數。
然後清了四種東西:
- 輸入日期早於任何預估紀錄的(638 筆):很多人一裝 App 就把舊成績輸進去,那不是預估,是自填。
- 六十天內重複輸入同一個分數的(55 筆):改日期、補輸入都會留下重複,第二筆的「預估」就是第一筆重設後的值。
- 預估本身就是上一筆正式成績的(37 筆):輸入成績後預估會重設到那個分數,如果之後沒再練,下一次輸入前的「預估」就是上次的成績。
- 練習太少或預估太舊的:輸入前至少要有 15 個開啟 App 的日子、14 天以上的紀錄,預估要離開過自填的起點,而且距離輸入不超過十四天。
清完剩下 140 組,來自 125 個帳號。這些成績是考生自己輸入的,沒有成績單核對,輸入錯誤和打錯日期都會留在裡面;但它不挑人,寄信來的和沒寄的都在。
整體:沒有偏差,排序很準
| 聽力 | 閱讀 | 總分 | |
|---|---|---|---|
| 平均誤差(實際減預估) | +2 | −8 | −6 |
| 中位數 | +5 | −2 | 0 |
| 平均絕對誤差 | 36 | 44 | 67 |
| 排序相關(Spearman) | 0.79 | 0.77 | 0.83 |
| 總分誤差在 ±50 內 | 56% | ||
| 總分誤差在 ±100 內 | 75% |
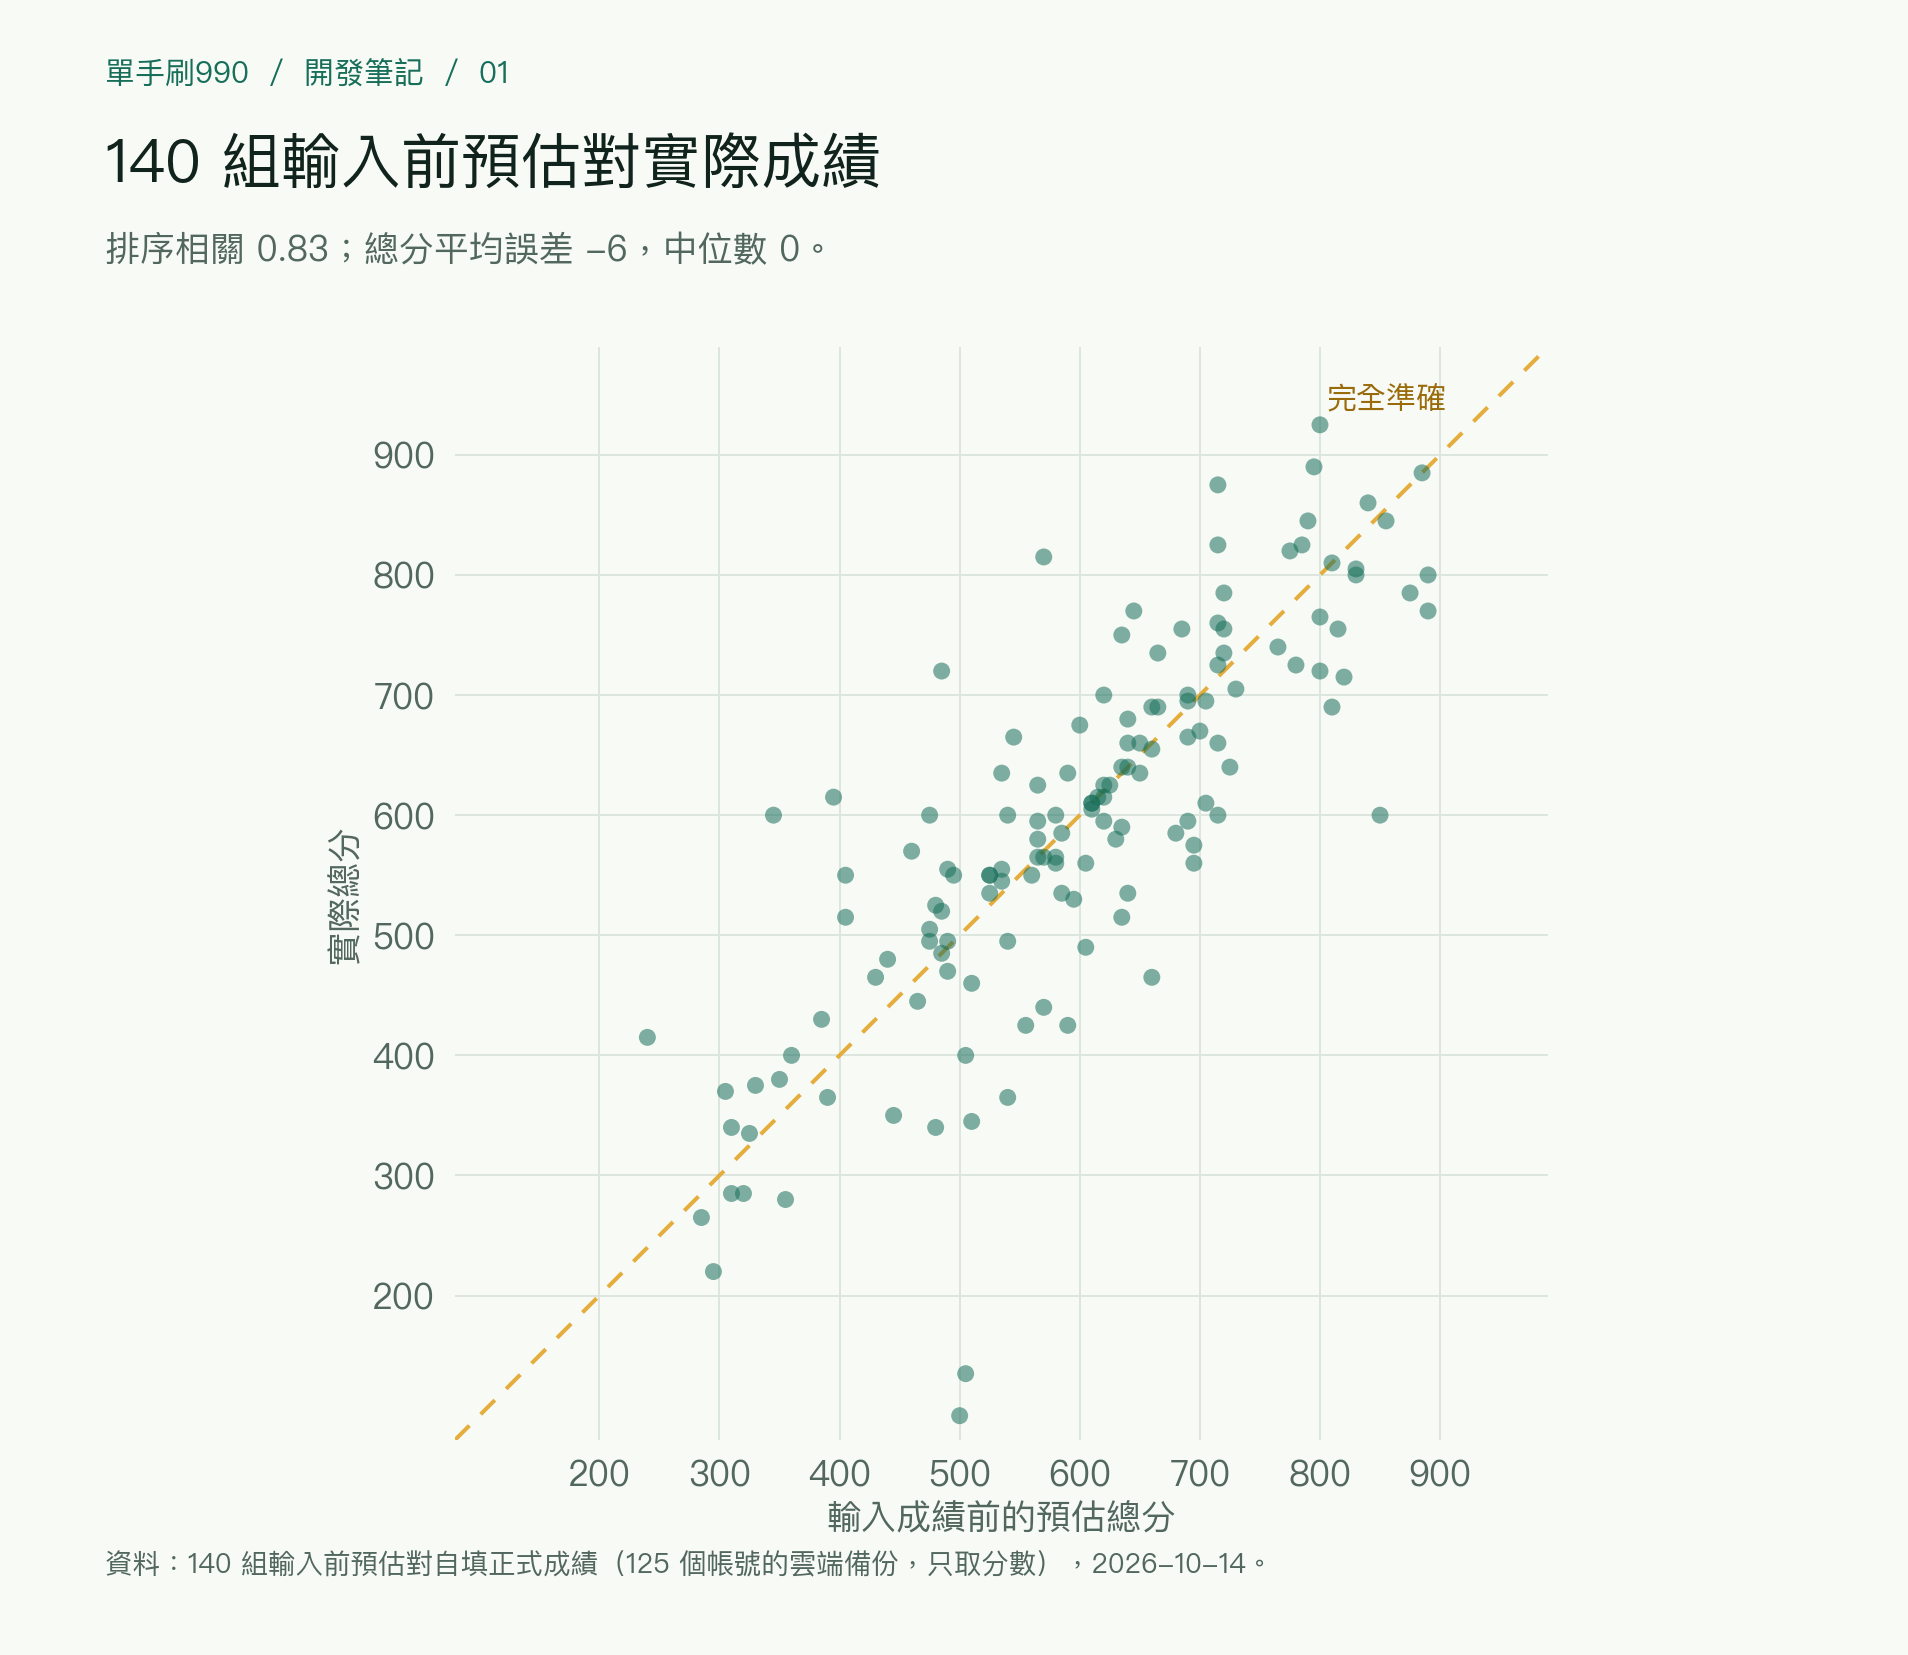
圖一:每一點是一次成績輸入,橫軸是輸入前的預估總分,縱軸是輸入的實際總分。對角線是「完全準確」。可放大的 SVG
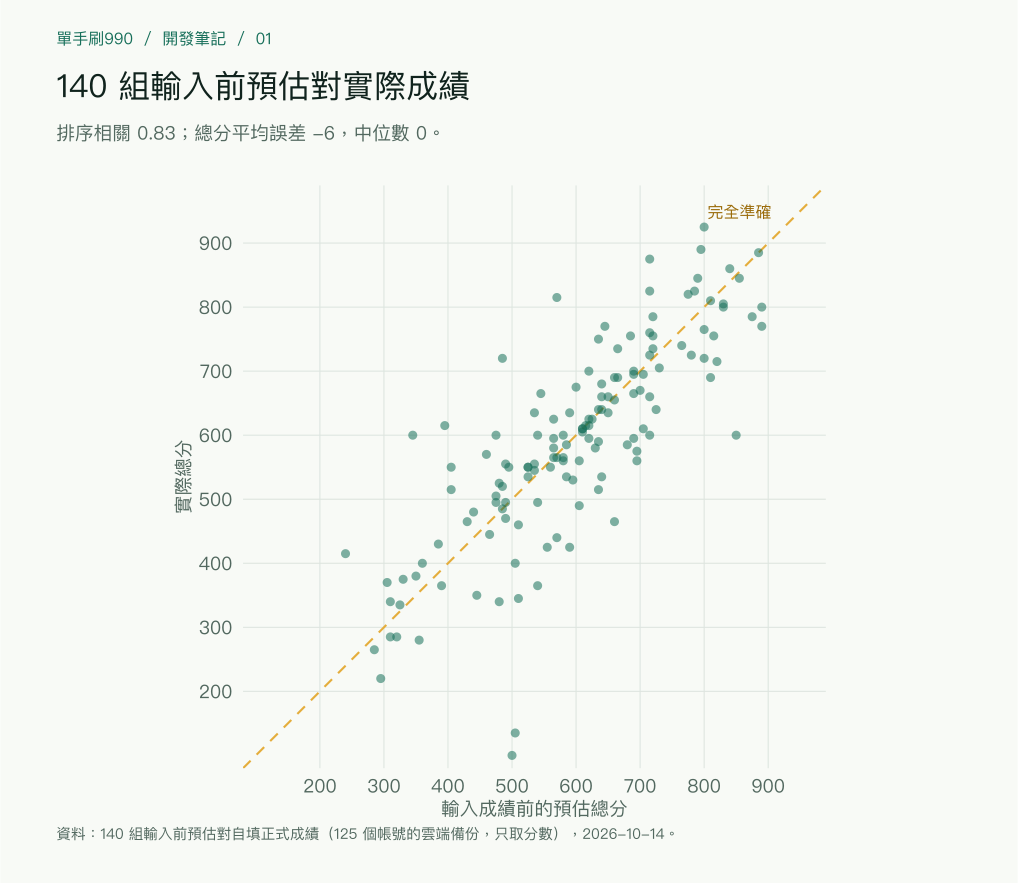
聽力平均高 2 分,閱讀平均低 8 分,總分平均低 6 分,中位數接近 0。以 140 組來說,這是「沒有系統性偏差」的意思。排序相關 0.83 的意思是:預估高的人,實際上大多也考得高,雖然每個人的數字會偏。
我們看錯的那件事:高分帶
把 140 組依預估分帶,和依實際成績分帶,兩張表的方向相反。
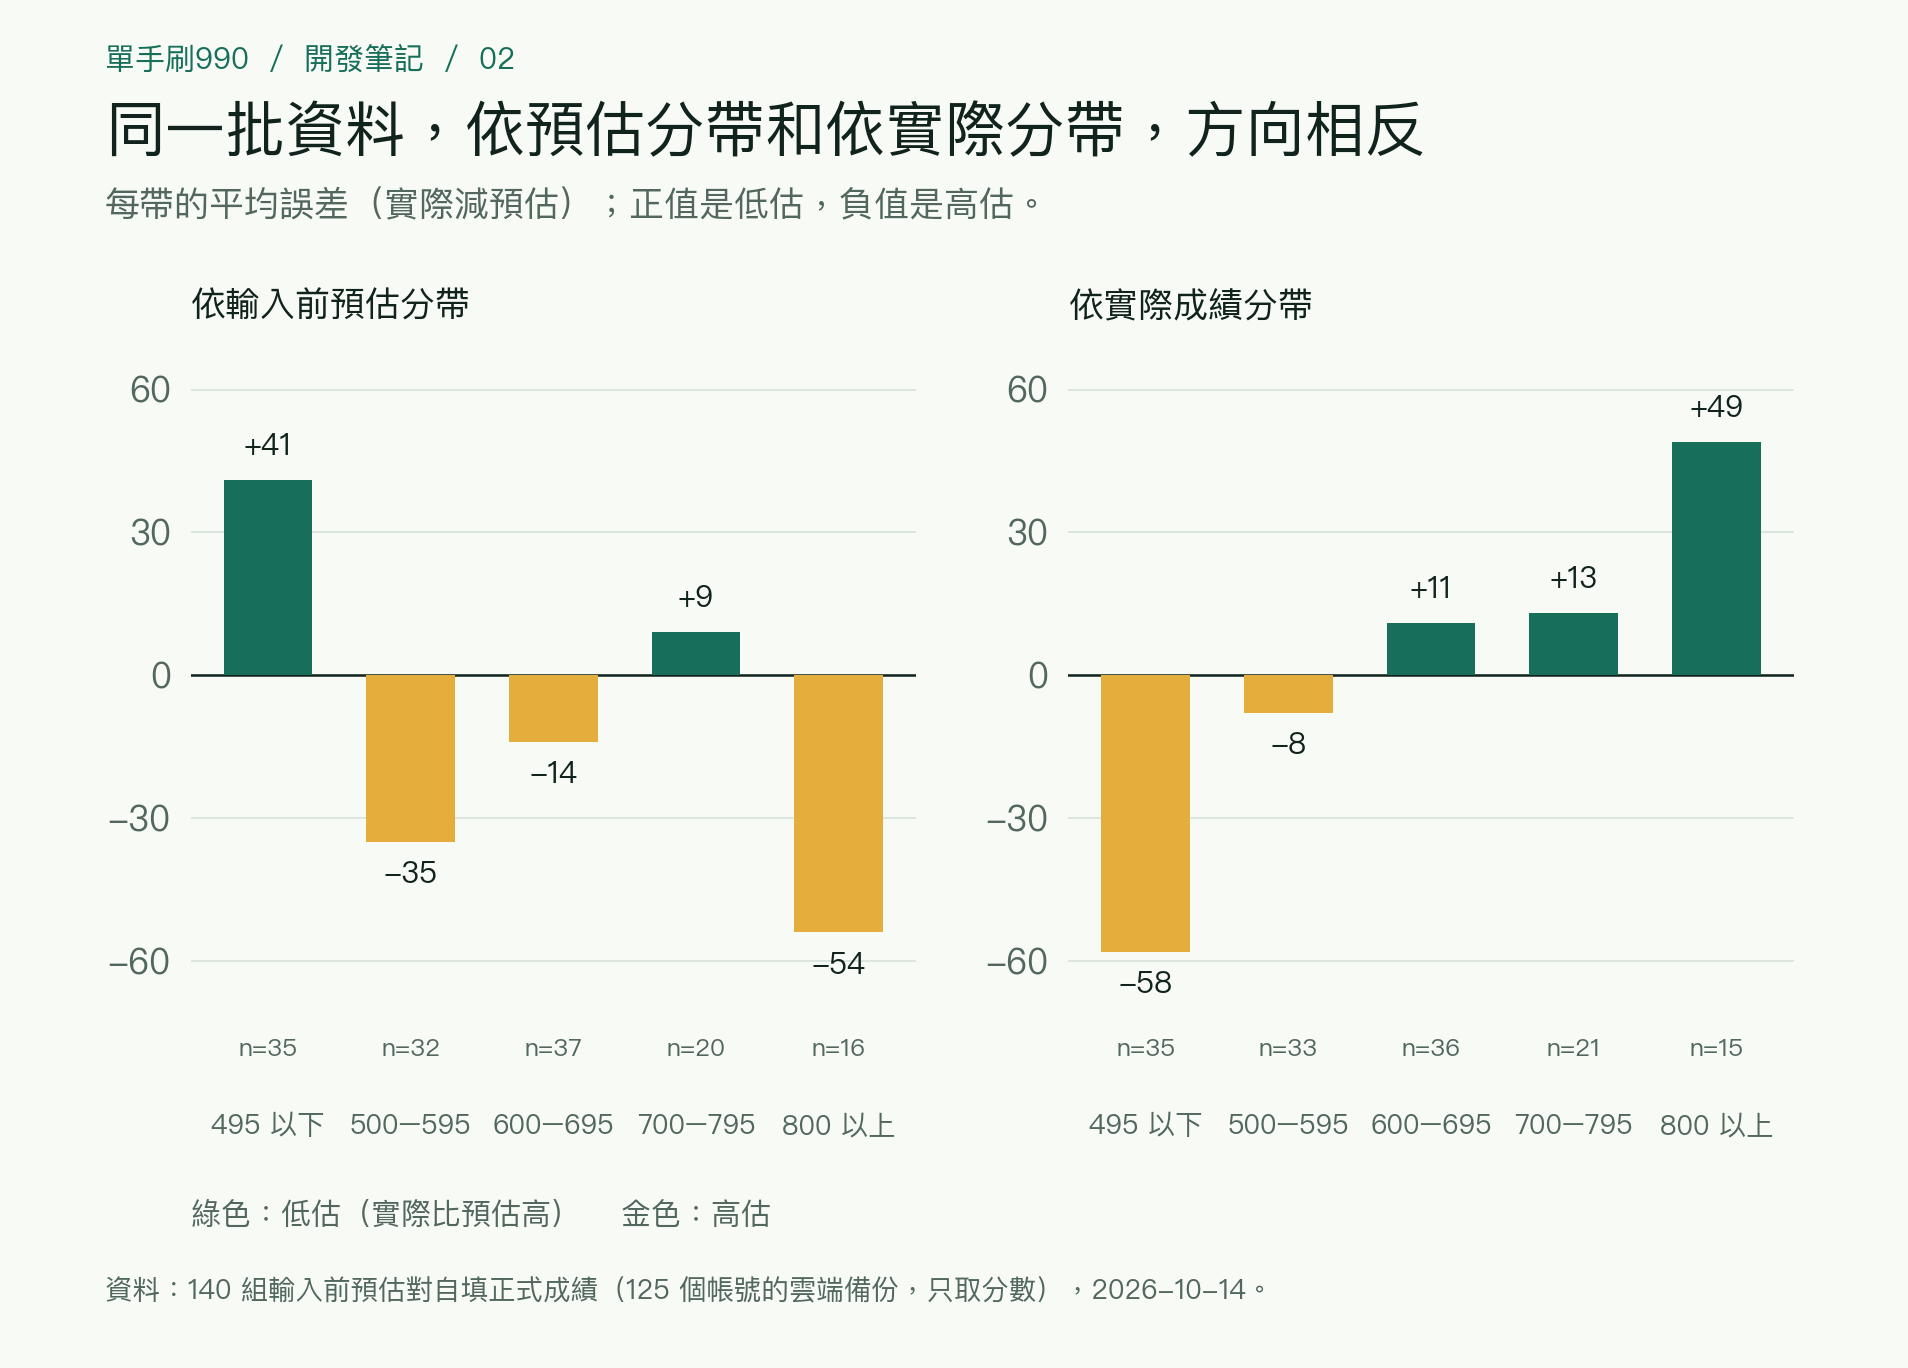
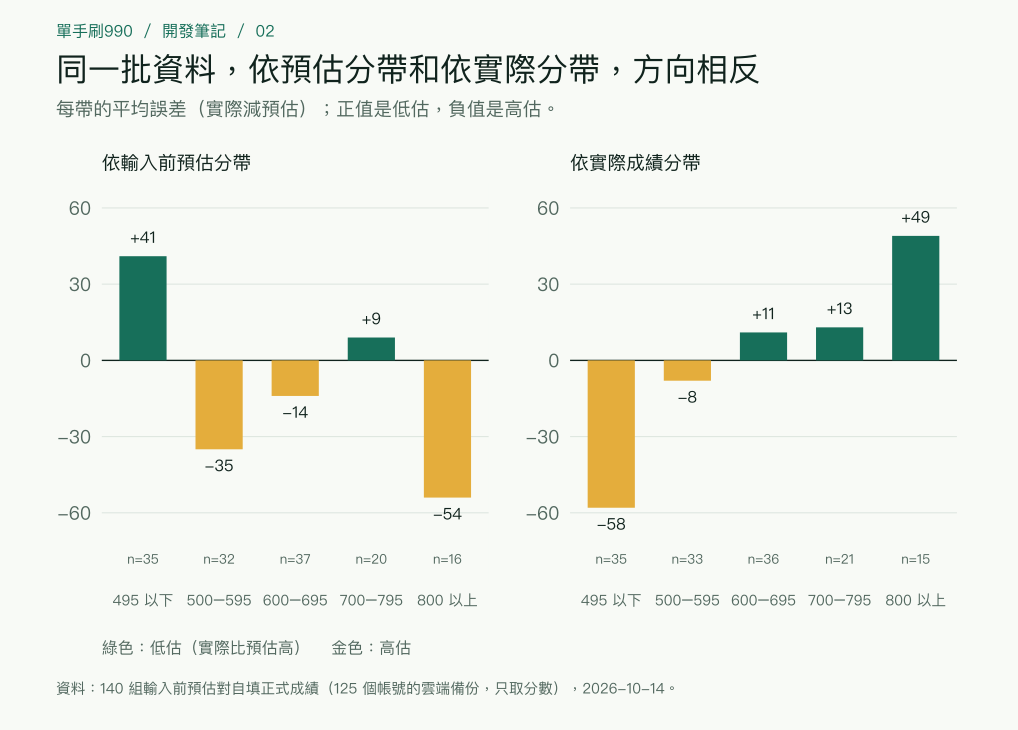
圖二:同一批資料分兩種方式分帶。左邊依輸入前的預估,右邊依實際成績。正值是低估(實際比預估高),負值是高估。可放大的 SVG
| 分帶方式 | 800 分以上 | 495 分以下 |
|---|---|---|
| 依預估分帶 | 平均高估 54(16 組,只有 12% 被低估) | 平均低估 41(35 組) |
| 依實際分帶 | 平均低估 49(15 組,60% 被低估) | 平均高估 58(35 組) |
兩張表都是對的,而且必然同時成立。只要預估有雜訊,實際考得高的那群人,就會有比較多是「預估沒跟上」的;實際考得低的那群人,則有比較多是「預估太樂觀」的。統計上叫均值迴歸,不是估分方法的毛病。
寄成績來的考生,是考得好的人:八張成績單裡,六張是 800 分以上。我們拿這八張看,就是用「實際成績」在分帶,自然看到高分帶被低估。如果真的照那個印象在高分帶把預估往上調,對「預估 800 以上」這群人來說,反而會把已經平均高估 54 分的數字再往上推。
這一段要記下來給自己看:用主動回報的樣本校正模型,方向會反。
站得住的發現,和我們以為有的
整體沒有偏差,不代表沒有事做。平均絕對誤差總分 67;如果預估本身完全準確、只剩考試本身的測量誤差,兩節各約 25 分的標準差合成總分約 35 分的標準差,對應的平均絕對誤差大約 28。我們是它的兩倍多,所以問題不在偏,在散。拆開看之後,站得住的只有一個半。
- 聽力的起點偏低。 預估聽力在 345 以下的 87 組,實際平均高 11 分,59% 被低估;這是依預估分帶,不是前面那種錯覺。它只說明這個分數帶的聽力預估偏保守,說不出原因:可能是新帳號的先驗把起點壓低,也可能是這個分數帶的聽力題偏難,這份資料分不出來。
- 半個:輸入過舊成績的人,之後偏向被低估。 140 組裡有 26 組的考生先前輸入過一次正式成績,這些人的下一次成績平均比預估高 9 分。用比較寬鬆的日期規則算,這個數字曾經是 27,我們一度把它當成「錨太重」的證據;收緊規則後只剩 9,而且會再考一次的人本來就偏向有進步的人,所以這是一個關聯,不是原因。我們把輸入成績的錨定強度調輕了一些,但那是判斷,不是這份資料證明的。
- 我們以為有的:低分帶的閱讀高估。 依實際總分分帶,495 以下的 35 組閱讀平均高估 43 分,看起來正是前面報告裡「不計時、最後幾題空白」的現象。但這又是用實際成績在分帶;同樣的 495 分以下,改依預估總分分帶,35 組的閱讀平均誤差是 +16,方向反過來。母體資料不支持「低分帶閱讀被高估」這個說法。不計時和空白題的問題在個別紀錄裡是真的,只是它沒有大到在母體裡留下痕跡。
至於「只練弱點,預估會下修」,在個人的紀錄裡確實看得到,但在 140 組裡沒有形成整體的偏差。原因是每一節的預估都是該節的 Part 各自估計後(聽力 Part 1 到 4,閱讀 Part 5 到 7),用考試的題數權重加總的,專練某個 Part 不會拖累同一節的別的 Part;會造成偏差的,是同一個 Part 裡只練難題、只練某幾種題型,那是下一步要處理的範圍。
還有一個常見的校正手法這裡也試過:把預估往母體平均「收」一點。實際成績對預估的迴歸斜率是 0.86,表示預估比實際略微極端;但照這條線收完,平均絕對誤差只從 67 變成 66。不值得做。
接下來會改什麼,不會改什麼
會改:
- 同一個 Part 裡依難度分層估計,再用固定的難度比例加總,讓「這週剛好被派到難題」不再拉動預估。七個 Part 都適用,聽力和閱讀一樣。
- 計時模考裡的空白題算進預估,當作答錯;母體裡看不到它的痕跡,但在個別紀錄裡它是真的,而且考場上就是這樣算的。
- 輸入舊成績的錨定強度調輕一些,讓之後的練習更快反映進步;上面說過,這是判斷。
- 把這次的比較固定下來:這張表以後每季用同一套規則重算一次,看聽力起點和錨定這兩件事有沒有變。
不會改:
- 不在任何分帶上加固定的分數,也不把預估往平均收。
- 不對聽力或閱讀加任何修正量;兩節的計算規則維持對稱。
秋豆麻袋,這 140 組也有但書
- 成績是考生自己輸入的,沒有核對。打錯分數、填錯日期、把模考當正式成績輸入,都在裡面。
- 比的是「輸入成績前兩天到十四天的預估」,不是嚴格的考前預估;從考試到收到成績再到輸入,中間通常隔了幾週,考生的實力可能已經變了一點。
- 800 分以上只有 15 到 16 組,495 分以下 35 組,兩端的平均都還在晃。
- 同一個帳號可能貢獻兩組(125 個帳號、140 組),兩次成績並不獨立。
- 140 組只佔 1,019 個輸入過成績的帳號的一小部分,大多數人輸入的是裝 App 之前的成績,那是校正起點,不是檢驗。
但八張成績單告訴我們的「高分帶要往上調」,在 140 組面前站不住,這一點是確定的。下次要調整預估方法,先看全部的人。
預估分數怎麼算,寫在〈多益預估分數怎麼算〉;第一次檢驗在〈多益預估分數準不準?〉;其中幾位考生的完整紀錄在實戰報告。單手刷990 的「輸入我的成績」在目標分數設定裡。