
所有文章 · 發布於 2026-10-20
「I before E, except after C」準不準?我們數了一萬個常用英文字,science 和 weird 都不聽話
「i 在 e 前面,除非前面是 c」大概是英文最有名的拼字口訣,可是 science、weird、their、eight 一個比一個不聽話。我們拿一份一萬字的常用字表、自己的單字庫和多益題庫實際數了一遍:照字面用,這條口訣在實際的英文文章裡大約只對三分之二,而「c 後面」反而是 cie 的字比 cei 多。這篇講它為什麼不準、ie 和 ei 為什麼這麼亂,以及加上一個條件之後,它其實相當好用的那個版本。
英國政府為什麼叫老師「別教 i before e」?
很多人學英文拼字時都背過這句:
I before E, except after C. i 在 e 前面,除非前面是 c。
所以是 believe、field、piece,但 receive、ceiling。聽起來乾淨俐落。
2009 年,英國兒童、學校及家庭部(Department for Children, Schools and Families)發給小學老師的拼字教材《Support for Spelling》第 106 頁,卻有這麼一句:
「i before e except after c」這條規則不值得教。它只適用於 ie 或 ei 唸成清楚的 /ee/ 音的字;如果不知道這一點,sufficient、veil、their 這些字看起來就都像是例外。
英國報紙當年六月大肆報導,好像政府要廢掉一條國寶級的規則。語言學家 Geoffrey Pullum 在語言學部落格 Language Log 上(2009 年 6 月 22 日)指出,很多報導把文件的意思講歪了。文件真正說的是:這條規則如果不加上「唸 ee 的時候」,sufficient、veil、their 這些字就都會變成例外;而真正需要「c 後面用 ei」的 ee 字又少到不如直接背——文件列的就是 receive、conceive、deceive(加上 receipt、conceit、deceit)、perceive 和 ceiling。
那麼,這條口訣到底有多不準?我們決定自己數。
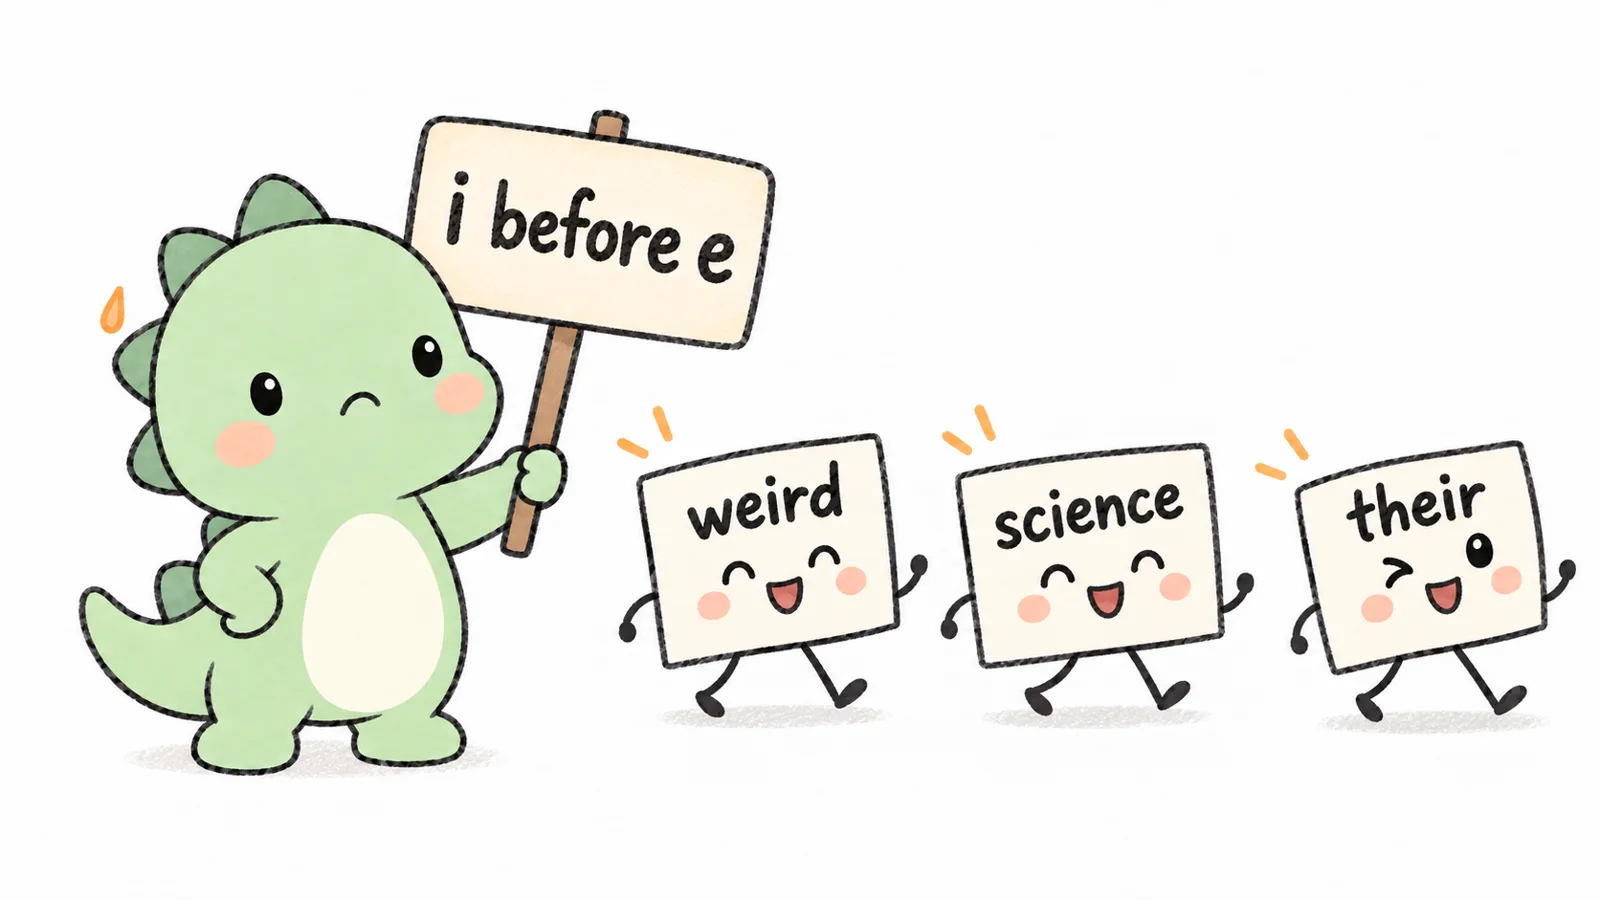
這條口訣到底準不準?我們數了一萬個字
怎麼數。 我們用三份資料:
- 常用字表:Robyn Speer 等人開發的 wordfreq 詞頻資料庫裡最常用的一萬個英文字。扣掉三十個人名、地名之類的專有名詞(Keith、Beijing、Leicester……),剩下 317 個含有 ie 或 ei 的字。
- 單字庫:單手刷990 字彙練習的 3,834 個單字,其中 106 個含 ie 或 ei。
- 多益題庫:單手刷990 閱讀和聽力題目裡讀者看得到的英文(文章、題目、選項、聽力逐字稿),大約 68 萬字,每出現一次算一次。
規則的判法很單純:ie 不在 c 後面、cei——算「對」;ei 不在 c 後面、cie——算「錯」。
結果:
| 資料 | 算法 | 口訣說對的比例 |
|---|---|---|
| 常用字表(317 個字) | 每個字算一次 | 81% |
| 常用字表,扣掉 y 變 ie 的字 | 每個字算一次 | 70% |
| 常用字表 | 依出現頻率加權 | 63% |
| 單字庫(106 個字) | 每個字算一次 | 68% |
| 多益題庫(約 68 萬字) | 每出現一次算一次 | 65% |
第一行的 81% 看起來還不錯,但它灌了水:317 個字裡有 127 個是 companies、studied、easier 這種「y 變 i 再加字尾」的字。它們拼成 ie,是因為另一條規則(y 改 i 加 es/ed/er),跟這句口訣無關。扣掉以後,只剩 70%。
依頻率加權更慘,因為最常用的那幾個字剛好都不聽話:their、being、either、foreign、eight、weight。光是 their 一個字,就佔了這份字表裡所有含 ei 的字出現次數的將近一半。
我們不是第一個這樣數的人。語言學家 Mark Liberman 2006 年在 Language Log 用 2001 年《紐約時報》新聞稿中隨機一個月、大約 870 萬字的語料算過:口訣說對的比例是 65%。他還算了另一條更偷懶的規則——「不管怎樣都是 i 在 e 前面」——結果是 67%,比原版還準。我們的常用字表也一樣:「一律 ie」在每個字算一次時對 84%,依頻率加權時對 66%,兩種算法都贏過原版口訣。
也就是說,口訣的後半句「except after c」不但沒幫上忙,還扣了分。
「except after c」更慘:c 後面反而多半是 cie
照口訣,c 後面應該是 ei。實際數一下:
| 資料 | cie 的字 | cei 的字 |
|---|---|---|
| 常用字表 | 17 個(society、science、species、ancient、efficient、sufficient……) | 9 個(receive、received、receipt、ceiling、perceived、conceived……) |
| 單字庫 | 15 個 | 5 個 |
c 後面,反而是 cie 比較多:常用字表裡多將近一倍,單字庫裡更是三倍。
再看那 9 個 cei:除了 ceiling,全都是 receive、perceive、conceive 這一家人。英國辭典編纂家 Henry Fowler 在 1926 年的《A Dictionary of Modern English Usage》裡就說得很清楚:「after c」這個例外,涵蓋的是拉丁文 capio(拿、取)的許多衍生字,例如 receive、deceit、inconceivable。換句話說,「except after c」其實不是一條關於字母 c 的規則,而是「receive 這一家人加上 ceiling」的簡稱。
為什麼 ie 和 ei 這麼亂?因為它們來自不同的地方
英文的 ie 和 ei 不是一套系統,而是好幾個語言、好幾個時代留下來的東西疊在一起:
| 單字 | 從哪裡來 | ie/ei 怎麼唸 |
|---|---|---|
| field、friend | 古英文 feld、frēond | ee、短 e |
| eight、weigh、height | 古英文 eahta、wegan、hīehþu | ay、ay、eye |
| their | 古諾斯語(維京人的語言)þeira | air |
| chief、piece | 古法文 chief、piece | ee |
| receive、deceive | 古法文 receivre,更早是拉丁文 recipere | ee |
| seize、leisure | 古法文 seisir、leisir | ee、短 e(美式唸 ee) |
| forfeit、counterfeit | 古法文 forfait、contrefait | 短 i |
| science、species、efficient | 拉丁文 scientia、speciēs、efficiēns | 分屬兩個音節,或跟 c 合成 sh 音 |
| protein | 1838 年瑞典化學家 Berzelius 命名,取自希臘文 prōteios(首要的) | ee |
| caffeine | 法文 caféine(café+-ine) | ee |
| weird | 古英文 wyrd(命運) | eer |
資料來源:Wiktionary 各詞條的字源;protein 的命名見英文維基百科〈Protein〉。
幾件看得出來的事:
- ie 和 ei 代表的聲音至少有五、六種:ee(field)、ay(eight)、eye(height、pie)、air(their)、短 e(friend)、短 i(forfeit)。一條只看字母順序的規則,不可能同時管住這麼多種聲音。
- science、species、efficient 的 i 和 e 根本不是一組。 sci-ence 是兩個音節;efficient 的 ci 合起來唸 sh。它們被算成「例外」,只是因為字母剛好排在一起。
- caffeine 也是拼起來的。 它是 café 加上化學名詞常用的字尾 -ine,e 屬於前半、i 屬於後半。
- eight、weigh、height 的 ei 後面都跟著 gh。 那個 gh 是以前唸出來的喉音留下的痕跡(我們在〈英文為什麼有不發音的字母?〉講過),而 ei 是它前面的母音的拼法。foreign 也在那篇出現過:它在中古英文裡寫成 forein(來自法文 forain),g 是後來才被塞進去的。
有一個常見的加長版口訣,想補上其中一部分:
I before E, except after C, or when sounded as A, as in neighbor and weigh.
加了「唸 ay 的時候用 ei」,eight、weigh、vein、reign、freight 就有了著落。可是 their、height、foreign、forfeit、leisure、science 還是不在裡面。
真正有用的版本:只管「唸 ee」的字
回到英國那份教材、還有 Fowler 都說過的那個條件:這條規則只管 ie/ei 唸成 ee(像 see 裡的那個音)的字。
When the sound is ee, it's i before e, except after c. 唸 ee 的時候,i 在 e 前面;c 後面例外。
Fowler 1926 年就是這樣寫的:這條規則「非常有用」,但只適用於「母音唸 e(即長音 ee)的音節」;seize 是「重要的例外」;碰到專有名詞則完全沒用。Pullum 2009 年也說,懂行的人從來都是連同「when the sound is ee」一起教。
加上這個條件,我們重新數一次。這次只看 ie/ei 在重音節裡唸 ee 的字(發音以美式發音辭典為準——常用字表用 CMU 發音辭典,單字庫用我們自己的音標——再人工逐一確認):
| 資料 | 照規則(ie 或 cei) | 例外 | 說對的比例 |
|---|---|---|---|
| 常用字表 | 49 個 | 6 個 | 89% |
| 單字庫 | 25 個 | 3 個 | 89% |
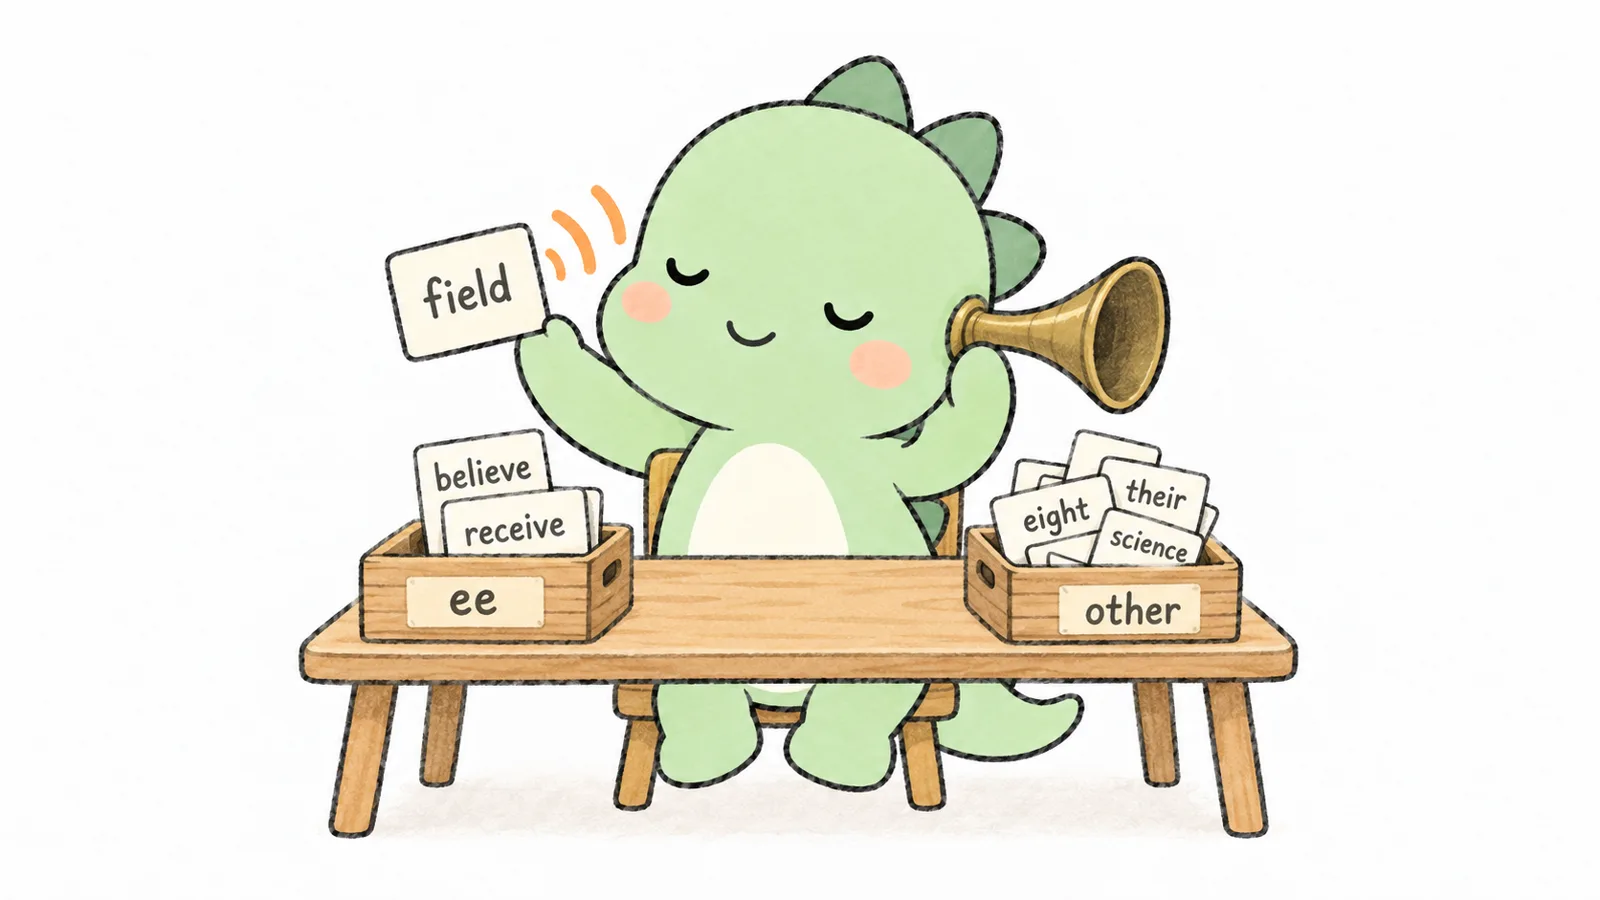
從三分之二,一下子跳到九成。常用字表裡剩下的 6 個例外是 either、neither、seize、seized、protein、proteins;單字庫是 neither、protein、seize。其中 either 和 neither 還要看你怎麼唸——很多英國人唸成「eye-ther」,那它們就根本不歸這條規則管。
所以,真正需要記的東西其實很少:
- 唸 ee 的時候,寫 ie:believe、achieve、field、piece、chief、brief、relief。
- c 後面唸 ee,寫 ei:receive、receipt、deceive、perceive、conceive、ceiling。基本上就是這一家人。
- 幾個要單獨背的例外:seize、protein、caffeine,還有 either、neither(如果你唸 ee)。weird 唸的是 eer,我們的嚴格算法沒有把它算進去,但它常被列為例外,一起記比較保險。
- 不唸 ee 的字,這條規則一律不管:eight、their、height、foreign、science、efficient……這些要靠聽和看,不能靠口訣。
你的語言也有這種口訣
用一句口訣管住一堆難拼的字,不是英文獨有的。中文也有:「橫戌、點戍、戊中空」,靠一筆橫、一個點或什麼都沒有,分開戌、戍、戊這三個長得幾乎一樣的字。
不過這句中文口訣有一個英文版沒有的優點:它只管這三個字,而且三個字都管得住。i before e 的問題正好相反——它想用一句話管所有含 ie 和 ei 的字,結果管不住。範圍縮到「唸 ee 的字」以後,它才變得跟這種口訣一樣可靠。
多益會碰到哪些 ie/ei 字?
在 ETS 公開的多益聽力閱讀官方範例試題裡,第 200 題問一封客訴 email 提到什麼問題,正確答案 (A) 是 He received the wrong item.;第 39 題問對話裡的女子為什麼說 I can't believe it。receive 和 believe,正好是口訣兩半各一個代表。
我們題庫裡這些字出現的次數(含變化形,例如 received、receiving 都算 receive):
| 符合口訣字面的字 | 次數 | 不符合口訣字面的字 | 次數 |
|---|---|---|---|
| receive | 712 | eight(含 eighteen、eighty) | 478 |
| receipt | 350 | weigh(含 weight) | 175 |
| brief(含 briefing) | 160 | neighbor/neighbour | 117 |
| field | 98 | efficient | 41 |
| ceiling | 60 | forfeit | 17 |
| believe | 49 | sufficient | 17 |
| achieve | 13 | leisure | 8 |
| relief(含 relieve) | 12 | foreign | 6 |
| perceive/deceive/conceive | 6 | seize | 3 |
很有意思的是:在一般的常用字裡,cie 比 cei 多;但在我們的多益題庫裡,cei 出現了 1,129 次,cie 只有 244 次。原因很簡單——商業英文天天在 receive 東西、開 receipt。所以「except after c」這半句雖然在一般英文裡不太準,卻剛好管住了多益風格英文裡最常見的兩個 ie/ei 字。
要誠實說的是:多益聽力閱讀是選擇題,你幾乎不必自己拼字。 認得 receipt、聽得懂 re-ceet,比會拼重要得多。拼字真正派上用場,是在你自己寫 email 的時候,或是去考多益口說寫作測驗(TOEIC Speaking & Writing),寫作部分要你自己寫回覆和短文。如果你想練,單手刷990 的「單字 → 自選練習 → 字彙拼字」會給你一個例句、空出一個字,讓你用螢幕鍵盤把它拼出來。
口訣不準,我們的數法也有但書
幾件事要說清楚:
- 數字會隨著字表和算法變動。 用不同的字表、要不要扣掉專有名詞、要不要扣掉 y 變 ie 的字、算「字」還是算「次數」,結果都會差個幾到十幾個百分點。但方向沒有變過:照字面用,三分之二左右;加上「唸 ee」,九成左右。
- 有些「ei」根本不是一組字母。 being 是 be+ing,seeing 是 see+ing,reimburse 是 re+imburse。我們的題庫裡 being 出現了 1,384 次,是頭號「違規者」——但沒有人會用口訣去拼 being。把這類字扣掉,題庫的分數會從 65% 升到 75%。
- 「唸 ee」的判斷是人工做的。 我們用美式發音,只算重音節裡的 ee。所以 weird、fierce、pier 這種 ee 後面帶 r 的音沒有算進去;species 結尾的 -cies 雖然也有點像 ee,但不在重音節上,也沒有算。如果把這些都算進去,例外會多幾個,結論不變。
- 口音會改變答案。 either、neither 在英國常唸 eye;leisure 在美國多半唸 ee、在英國唸短 e(我們的發音辭典標的是短 e,所以沒有算它;算進去就多一個例外)。同一個字,對一個人是例外,對另一個人根本不歸這條規則管。
- 我們的題庫不是 ETS 的考題。 題庫是我們自己寫的多益風格題目,字頻反映的是我們的寫法;範例試題只有一份,題數也不多。
結語:一條口訣,加上五個字就好用了
「I before E, except after C」不是錯的,它只是少說了五個字:when the sound is ee。
少了這五個字,它要管的是 eight、their、science、foreign、being——一群唸法、來歷完全不同的字,難怪三次裡只對兩次。加上這五個字,它管的只剩 believe、field、piece 和 receive 這一家人,十次裡對九次,剩下的例外一隻手數得完。
至於那份被報紙罵慘的英國教材,它說的其實就是這件事。只是「這條規則要加條件才能用」不太像新聞標題,「英國政府廢除 i before e」這種才像。
連考試自己的名字 TOEIC,都是 e 在 i 前面——不過那只是 English 和 International 的字首剛好排在一起,不算違規。
單手刷990 的「單字 → 自選練習 → 字彙拼字」可以用螢幕鍵盤拼出例句裡空掉的單字,免費使用。同系列的〈英文句子可以用介系詞結尾嗎?〉講六條學校教的文法規則是怎麼來的,這篇算是它的拼字版;〈英文為什麼有不發音的字母?〉講 eight 的 gh 和 foreign 的 g;〈英式拼法與美式拼法的差別〉講 colour 和 color(還有 neighbour 和 neighbor)為什麼會分家。